
6.5 KiB
sourceTitle, sourceUrl, sourceRequestedUrl, sourcePublishedAt, sourceSummary, author, coverImage, adapter, capturedAt, conversionMethod, kind, language, summary
| sourceTitle | sourceUrl | sourceRequestedUrl | sourcePublishedAt | sourceSummary | author | coverImage | adapter | capturedAt | conversionMethod | kind | language | summary |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| AI handles incidents, engineers lose touch with their systems | https://www.sylvainkalache.com/blog/ai-handles-incidents-engineers-lose-touch-with-their-systems | https://www.sylvainkalache.com/blog/ai-handles-incidents-engineers-lose-touch-with-their-systems | 2026-09-04 | AI-assisted incident response can lower MTTR while leaving engineers less prepared for the complex incidents automation cannot solve. | Sylvain Kalache | https://www.sylvainkalache.com/blog/ai-handles-incidents-engineers-lose-touch-with-their-systems/social-card.jpg | generic | 2026-09-14T05:51:12.148Z | defuddle | generic/article | zh-CN | AI 辅助的事故响应能降低平均修复时间(MTTR),但也会让工程师对自动化无法解决的复杂事故准备不足。 |
AI 处理事故,工程师与系统渐行渐远
2012 年我在 LinkedIn 担任 SRE(站点可靠性工程师)时,曾设计过一个能自我修复、并从既往事故中学习的系统。那时的 AI 能力远不及今天,这个系统最终停留在了原型阶段——但如今,这一切已经成为现实。
这些工具无所不能:检查告警、提出假设、查询遥测数据、关联最近的部署,甚至亲自实施修复。看到这一幕我很欣慰,但也有一个重大隐忧:我们正在与自己的系统渐行渐远。
这些工具解决常规事故的能力越强,人类响应者得到的实战练习就越少。而一旦自动化无法解决的高严重性事故降临,值班工程师将陷入困境。
自动化把人留在最难的事故里
这些 AI 辅助的事故响应工具,如今更常被称为 "AI SRE"——一个我不太喜欢的叫法——在许多方面都堪称惊艳。尤其当它们深夜处理掉一起常规事故,让你不必为了容量问题被叫醒时,那种感觉格外神奇。
问题在于,常规事故恰恰是响应者"安全地"培养对系统行为与故障直觉的方式。当 AI 遇到一个从未见过的硬骨头、无法解决时,工程师不得不在实战经验比以前更少的情况下接手。
人因工程研究者 Lisanne Bainbridge 在她 1983 年的著名论文《自动化的讽刺》中描述了这一悖论:自动化减少了操作员练习常规工作的机会,却让他们继续为各种新型异常状况负责。她因此主张,操作员需要比自动化之前更高的技能,接受更多的训练。
我预测,未来几年大多数事故的平均 MTTR(平均修复时间)都会因为 AI 辅助事故响应而下降,但复杂事故的解决时间会扶摇直上——因为响应者早已与系统脱节,调查起来举步维艰。
航空业为罕见的故障训练飞行员
我们可以从航空业汲取灵感。
飞机的自动化承担了大部分驾驶工作,但飞行员依然要为自动化无法应对的局面负责:发动机故障、仪表失灵、中断起飞、失速,以及其他异常状况。
这些事件极为罕见。以现代涡扇发动机为例,每 10 万发动机飞行小时的空中停车次数不到一次。换言之,这个概率低到民航飞行员可能整个职业生涯都不会在模拟机之外遇上一次。
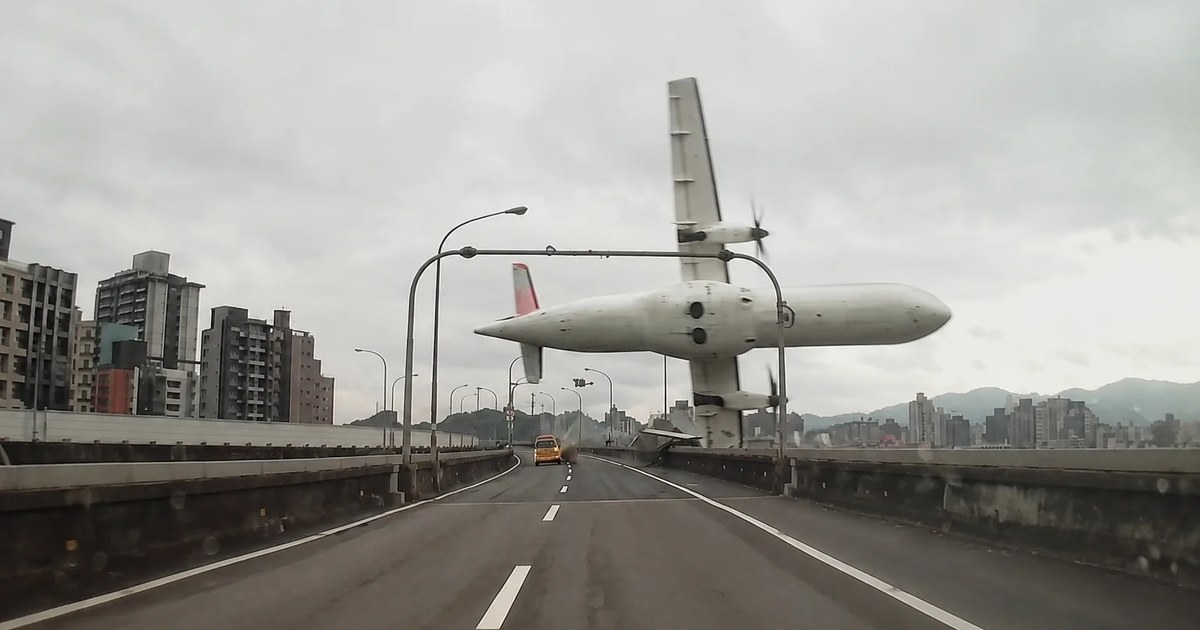
然而一旦故障发生,飞行员必须迅速且正确地作出反应。以复兴航空 235 号班机为例:起飞后不久,右发动机的螺旋桨自动顺桨。虽然飞机设计上可以依靠左发动机继续飞行,机组却错误判断了问题。从第一声警报响起,仅仅 117 秒后,飞机失速坠毁。
民航飞行员会定期回到模拟机,演练罕见的紧急情况。根据美国 FAA 的规定,机长每六个月必须完成一次复训或熟练性检查,内容包括起飞时发动机故障等场景。
虽说大多数软件事故不会危及生命,但这不能成为我们不精进手艺的理由。事实证明,制造出问题的技术,同样能帮助我们弥合问题。
软件行业需要事故模拟器
在我任职的事故管理公司 Rootly,我们与 Uptime Labs 合作,通过逼真的事故模拟来实践这一理念。在一场模拟的电商宕机中,工程师坐上事故指挥席,一边使用可观测性工具排查,一边在 Slack 里与由大模型驱动的各方角色协调。
效果非常真实。你必须在稳住响应节奏、应付 CEO 与客服追问的同时,查明究竟哪里出了问题。你能练习到事故中最关键的技能:从残缺不全的信息里理出头绪、清晰沟通、协调众人,以及真正把一次响应跑完。
AI 也能帮着守住这些技能
那么,把 AI 当作教练呢?响应者可以让智能体讲解它采取过的步骤、检查过的信号,以及诊断背后的证据。
但讲解与观摩代替不了练习。看小威廉姆斯打球你或许能学到一点门道,但想学会网球,你得上场——事故响应亦复如是。
我职业生涯里有超过五年时间,都在围绕进步主义教育打造一所软件工程学校:做中学。学校是线下的,但我们没有老师;学生不做讲座的听众,而是动手做项目。当 Dropbox 告诉我,他们招去的毕业生在排障上仍显生涩时,我便设计了这样一批项目:给学生一套坏掉的基础设施,让他们诊断并修复。对大多数动手技能,我相信亲自动手远比被动听讲有效得多。
事故模拟应成为值班就绪的一部分
随着大模型接手越来越多的工作,工程团队面临"理解债务"累积的风险——系统实际如何运转,与响应者对其的理解之间,裂痕会越来越深。
工程师应当定期与自己守护的系统打交道,处理陌生的故障,练习在压力下工作,并预演 SEV0(最高级别事故)所需要的协调与沟通。桌面推演和混沌工程并非新事物,但在大模型时代,练习的意义前所未有地重大。
研究者 Bainbridge 的建议是:让操作员定期亲自上手,并用模拟防止技能退化。这正是自动化的讽刺之处——它越成功,人类在它失灵的那一刻就越没有准备。
Sylvain Kalache
Rootly 的 AI Labs 负责人兼开发者关系(DevRel)工程师。曾任 LinkedIn SRE,Holberton School 联合创始人。