
302 lines
21 KiB
Markdown
302 lines
21 KiB
Markdown
# 调优 conntrack 垃圾回收,解决神秘的 Kubernetes Pod 启动超时
|
||
|
||
- **期号**: SRE Weekly Issue #532(2026-08-31)
|
||
- **作者**: Jorrick Sleijster — Adyen
|
||
- **链接**: https://www.adyen.com/knowledge-hub/inside-cilium-cni-solving-kubernetes-pod-setup-timeouts
|
||
|
||
## 简介
|
||
|
||
哇哦。距离我上次撞上一张爆满的 conntrack 表已经好几年了,这次又是个有趣的新花样。
|
||
|
||
## 正文
|
||
|
||
[Knowledge Hub](https://www.adyen.com/knowledge-hub)
|
||
|
||
文章
|
||
|
||
# Cilium CNI 内幕:破解神秘的 Kubernetes Pod 启动超时
|
||
|
||
深度剖析 Adyen 数据平台工程团队如何调查并解决 Cilium CNI 连接跟踪垃圾回收中的线性时间扩展瓶颈,修复高资源节点上神秘的 Kubernetes Pod 启动超时。
|
||
|
||
一年前我就很清楚:一行配置就能搞垮 Kubernetes 的整个网络栈。但如果有人告诉我,几小时前就已终止的 Pod 留下的残余物能阻止新 Pod 启动,我会以为他们在开玩笑。
|
||
|
||
在高性能网络里,35 秒就是一辈子。这是以每秒最多 20 万条的速度遍历我们 700 万条连接跟踪表所需的时间。在我们的 1600 万条峰值下,这种顺序查找可能长达 80 秒,导致 Cilium CNI 超时,新 Pod 无法在受影响的节点上启动。
|
||
|
||
我们在 Adyen 通过跟踪系统调用、查阅代码库和分析 eBPF 内部机制,发现了这个线性时间行为。这次调查揭示了我们的多样化负载如何把连接跟踪表的垃圾回收算法变成了关键瓶颈。
|
||
|
||
## 我们的环境:为什么我们不一样
|
||
|
||
在 Adyen,我们在全部 100 多个 Kubernetes 集群上运行 Cilium CNI。从 Calico 切换到 Cilium 时,我们就知道要让它适配生产负载会面临挑战。与 Adyen 内部的其他 Kubernetes 环境相比,我们的生产大数据集群有一个独特的使用模式:
|
||
|
||
**从 HDFS 提取数据**。我们的基础设施依赖超过 500 个数据节点。Trino 是我们对 HDFS 压力最大的工作负载之一,它对存储在 HDFS 上的数据执行分析查询。由于 HDFS 的分布式特性,每下载一个文件都需要与这 500 个节点中的任意一个建立新连接。因此,高峰时段单个 Pod 每分钟可产生约 5 万条连接。
|
||
|
||
**Pod 频繁更替**。我们在集群上启动的很多 Pod 运行的是批处理任务,比如 Spark 任务。它们存活时间从 1 秒到几个小时不等。
|
||
|
||
**工作负载种类繁多**。有些工作负载极其消耗 CPU,比如执行复杂 join 和转换的 Spark Pod,但网络连接相对较少。另一些则网络极其密集,比如 Trino Pod 查询 HDFS 上成千上万的小文件,每个文件都需要新连接。这产生了大量短命连接,给连接跟踪表造成巨大压力。
|
||
|
||
此外,我们的机器比 Adyen 内部大多数 Kubernetes 集群的机器更强大:
|
||
|
||
- 64 物理核、512GB 内存的机器
|
||
- 128 物理核、2TB 内存的机器
|
||
|
||
当时我们的环境是 Kubernetes 1.31.7 和 Cilium 1.16.5。我们给出这些具体版本,方便感兴趣的读者把我们的发现与相关代码对应起来。
|
||
|
||
为了支撑我们独特的工作负载,我们逐步调优了 Cilium:加大 DNS 代理超时、扩大连接跟踪表容量、提高 API 限流阈值、精简"安全标签"。这套配置让我们克服了一个又一个挑战,除了一件事:
|
||
|
||
**`Failed to create pod sandbox: rpc error: code = Unknown desc = failed to setup network for sandbox "0fecf4844d3f8f2df218f09d91f9698bb424e2166551952f46fd7638f4757cf2": plugin type="cilium-cni" failed (add): unable to create endpoint: Cilium API client timeout exceeded`**
|
||
|
||
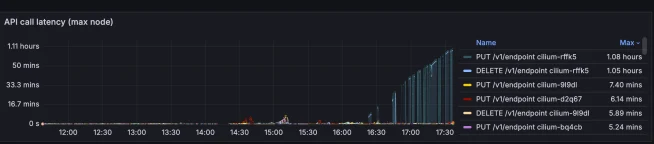
Kubernetes 会创建 Pod、启动沙箱,然后尝试用 Cilium 配置网络。这个操作会超时。从那一刻起,同一节点上任何其他 Pod 的启动都会跟着超时。此外我们注意到,在受影响的节点上,DELETE /v1/endpoint 和 PUT /v1/endpoint 这两个负责添加和删除 Cilium endpoint 的路由,其 API 耗时也增加了。从下面的图中可以清楚地看到:从下午 4:20 开始,endpoint 调用时延随时间线性增长,说明 endpoint 的创建和删除永远无法完成。
|
||
|
||
|
||
|
||
需要说明的是,这些集群只用于分析处理和大数据负载。这个问题在违反任何 SLO 之前就被发现、分析并彻底解决。此外,由于我们的大数据环境与核心交易链路隔离,这个问题从未影响我们的实时支付处理管道或商户交易。
|
||
|
||
## 症状:出了点问题,但出了什么问题?
|
||
|
||
首先,我们在 Cilium Agent 日志里没有找到相关超时。我们开启了 debug 日志,希望能找到隐藏的错误。什么都没有。日志给了我们宏观图景,却没有揭示瓶颈。
|
||
|
||
但我们确实从调试故障节点中学到了一些有价值的东西:
|
||
|
||
- 列出故障节点上的所有 endpoint 会超时:cilium endpoint list
|
||
- 列出某个 endpoint 的日志正常,并且显示该 endpoint 卡在 regenerating 阶段:cilium endpoint log <ENDPOINT_ID>
|
||
- 用 kubectl get ciliumendpoint 请求 endpoint 状态显示它仍在 regenerating,而 endpoint 的 Kubernetes manifest 显示为 ready 状态
|
||
- 检查 /var/run/cilium/state 下的文件系统,发现 endpoint 文件夹带有 _next 后缀,表明它们没有成功完成
|
||
|
||
这证实了我们的猜测:问题出在 Cilium agent 层,而不是 kubelet 或 CNI 插件层。但为什么,我们仍然不知道。
|
||
|
||
## 幕后:Cilium 如何为一个 Pod 配置网络
|
||
|
||
在深入调试之前,有必要了解当 Pod 启动、Cilium 为其配置网络时会发生什么。
|
||
|
||
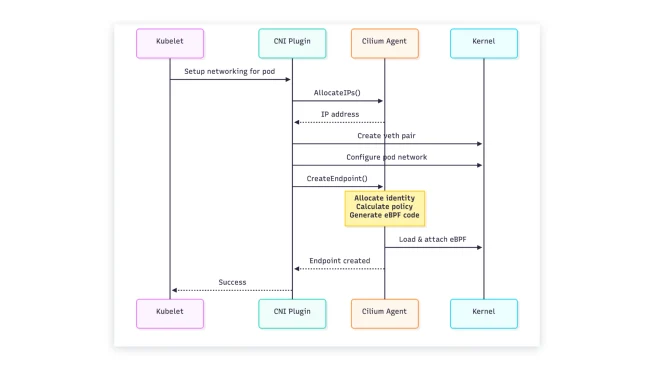
整个过程从 Kubernetes 把 Pod 分配到某个节点开始。kubelet 发起 Pod 设置,调用配置好的 CNI 插件(在我们这里是 Cilium)。Cilium CNI 插件执行若干操作:
|
||
|
||
1. **使用 IPAM(IP 地址管理)分配一个 IP**
|
||
2. **创建链路设备**(我们的配置中是 veth 对:一端在主机的网络命名空间,一端在 Pod 里)
|
||
3. **配置 Pod 网络**:设置 IP 地址、配置路由、设置 sysctl 参数
|
||
4. **通过 Cilium agent API 创建一个 Cilium endpoint**
|
||
5. **使用 Pod 标签检索或分配安全身份**
|
||
6. **为该 endpoint 计算网络策略**
|
||
7. **生成、编译并注入 eBPF 代码**到内核
|
||
8. **向 kubelet 返回成功**
|
||
|
||
关键要理解的是:创建 Pod(也就是创建 endpoint)时,CNI 插件会调用 Cilium agent——它以 DaemonSet 的形式运行在每个节点上。agent 承担繁重的工作:管理 eBPF map、处理连接跟踪、应用网络策略,等等。
|
||
|
||
以下是流程的简化视图:
|
||
|
||
|
||
|
||
这个过程中至关重要的一步发生在创建 endpoint 时:Cilium 会触发连接跟踪表的垃圾回收,以验证 Pod 的 IP 没有残留上次运行留下的连接。scrubIPsInConntrackTable 函数执行这一操作:扫描整张连接跟踪表,找出并删除相关条目。
|
||
|
||
垃圾回收失败的后果很严重。过期条目会无限制累积;虽然我们的表可以容纳多达 1600 万条,但真正的瓶颈在于每个新 Pod 都必须做的那次强制扫描。这个清理步骤对缓解 IP 地址重用冲突至关重要,确保新 Pod 不会继承前一个 Pod 的任何开放连接。
|
||
|
||
我们的故事从这里才真正开始。
|
||
|
||
*注:* [Arthur Chiao 对 Cilium CNI 实现的精彩深潜](https://arthurchiao.art/blog/cilium-code-cni-create-network/) *为我们理解 CNI 流程提供了大部分基础。虽然 Arthur Chiao 是几年前写的,但核心概念仍然适用,对任何想理解 Cilium 内部机制的人来说都是无价资源。*
|
||
|
||
## 深入兔子洞:追踪根因
|
||
|
||
### agent 到底在做什么?
|
||
|
||
我们需要看到 Cilium agent 挂起时在做什么。于是请出 pprof——Go 自带的分析器。我们在 Cilium 配置里启用了 pprof,并在一个故障节点上 spawn 50 个 Pod 后立即抓取 trace。
|
||
|
||
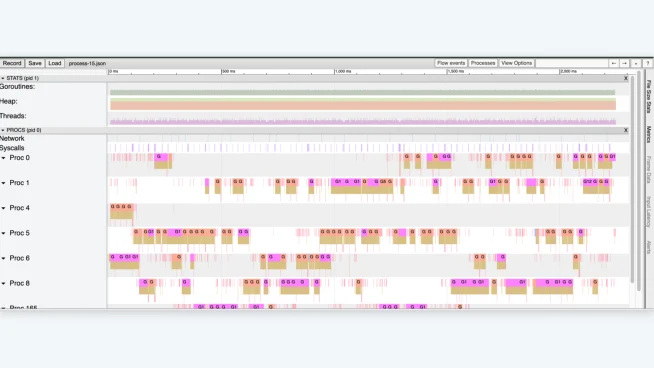
CPU 和内存 profile 一开始没暴露什么。但当我们打开执行 trace,时间线视图精确显示了每个 goroutine 在做什么,一切豁然开朗。
|
||
|
||
|
||
|
||
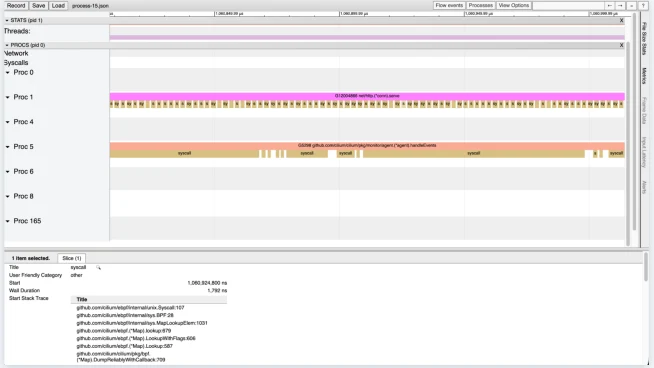
我们看到长时间运行的 goroutine 把全部时间花在系统调用上。放大之后,模式浮现了:
|
||
|
||
|
||
|
||
agent 在一个紧密循环里做 BPF 系统调用:nextKey()、lookup()、nextKey()、lookup(),一遍又一遍。agent 用这些系统调用遍历 eBPF map:
|
||
|
||
1. **nextKey(currentKey)** — 获取 BPF map 中 currentKey 之后的下一个 key
|
||
2. **lookup(key)** — 获取与 key 关联的值
|
||
|
||
我们来算笔账。我们选取了一段 35 毫秒的片段,数出 14,916 次系统调用。也就是每秒 426,171 次系统调用。由于从 eBPF map 取每个元素需要两次系统调用(next + get),我们每秒大约遍历 21.3 万条。
|
||
|
||
由于 Cilium 是用户态进程,每次通过系统调用访问或操作 map 都会引发一次上下文切换。上下文切换就是 CPU 暂时挂起用户态进程(Cilium)、进入内核执行代码(处理 BPF 系统调用)、再恢复用户态进程的过程。这涉及保存和恢复 CPU 寄存器与内存空间的全部状态,开销巨大,是延迟的主要来源。
|
||
|
||
这里的关键洞见是:这是一个顺序操作。你无法并行化,因为需要当前 key 才能拿到下一个 key。即使在我们的强力服务器 CPU 上,这也已经是我们能达到的最大速度。trace 里还有一个重要细节:这一切发生在 scrubIPsInConntrackTable 函数里——就是创建 endpoint 时清理连接跟踪表的那个函数。
|
||
|
||
## 为什么这么多系统调用?连接跟踪表
|
||
|
||
这时我们想起了在 cilium status --verbose 里看到的东西:
|
||
|
||
```
|
||
BPF Maps: dynamic sizing: on (ratio: 0.005000)
|
||
Name Size
|
||
TCP connection tracking 16777216
|
||
Non-TCP connection tracking 14232516
|
||
...
|
||
```
|
||
|
||
我们的 TCP 连接跟踪表最大容量 1600 万条,是 2TB 内存机器默认值 800 万条的两倍。几个月前,我们刻意在 Helm Chart 里配置了 `cilium_bpf_map_dynamic_size_ratio: 0.0050`,预期连接跟踪容量会随各节点类型的内存按比例扩展。当时这是一次有计划的扩容调整,为了防止 512GB 内存机器在高吞吐负载下连接跟踪耗尽。这个配置按预期支撑了我们独特的工作负载演进,但随着流量增长,更大的表与垃圾回收自动扩缩算法在 2TB 高资源节点上的交互,催生了一个新的扩展挑战。
|
||
|
||
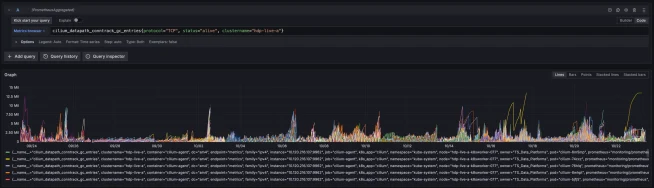
但表里实际有多少条目?我们用 `cilium bpf ct list global` 列了出来,显示约 700 万条。但有意思的是:当我们把 expires 字段的时间戳和系统运行时间对照,发现绝大多数条目早已过期,有的已经过期好几个小时。这把我们的目光直接引向垃圾回收机制。
|
||
|
||
现在算账变得有意思了:
|
||
|
||
- 最大遍历速度:约每秒 20 万条
|
||
- 当前表规模:700 万条
|
||
- 遍历当前表耗时:35 秒
|
||
- 最大表规模:1600 万条(最坏情况)
|
||
- 遍历整张表耗时:80 秒
|
||
|
||
也就是说,每次创建或删除一个 endpoint,我们都要花最多 35 秒遍历连接跟踪表,最坏情况最多 80 秒。别忘了我们的 CNI 超时上限是 90 秒。
|
||
|
||
但等等,如果条目已经过期,为什么垃圾回收器不清理它们?
|
||
|
||
## 为什么过期条目没被清理?出了岔子的垃圾回收
|
||
|
||
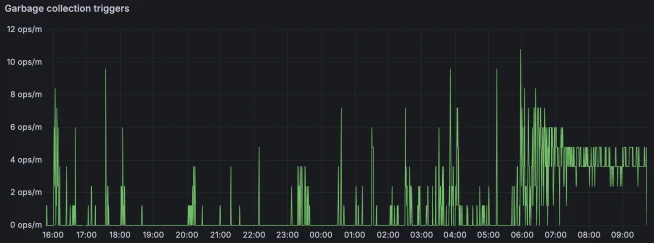
Cilium 为连接跟踪表提供了垃圾回收。看指标,GC 触发得非常频繁:
|
||
|
||
|
||
|
||
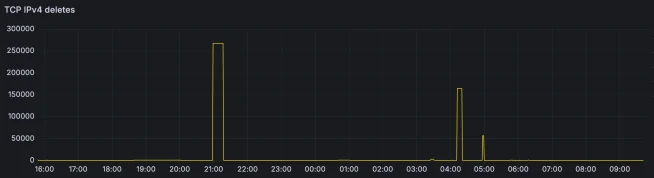
但当我们看垃圾回收器实际删了什么,问题出现了:
|
||
|
||
|
||
|
||
垃圾回收器频繁运行,但大部分时间几乎什么都不删。只有偶尔会删除大量条目。
|
||
|
||
深入代码后,原因浮出水面。Cilium 有两种 GC 操作:
|
||
|
||
1. **Endpoint 专属清理**:创建或删除 endpoint 时,清理匹配该 endpoint IP 的条目
|
||
2. **周期性过期条目清理**:按时间间隔运行,删除所有过期条目
|
||
|
||
指标中几乎所有的频繁 GC 都是 Pod 创建和删除触发的(第 1 类 endpoint 专属清理)。而删除过期条目的周期性清理(第 2 类)几乎没怎么跑。
|
||
|
||
为什么?因为 GC 间隔根据删除量自动扩缩:
|
||
|
||
```go
|
||
// 从 Cilium 源码简化
|
||
func GetInterval(interval time.Duration, maxDeleteRatio float64) time.Duration {
|
||
if maxDeleteRatio > 0.25 {
|
||
// 删除了超过 25% 的条目 → 更频繁地 GC
|
||
interval = time.Duration(float64(interval) * (1.0 - maxDeleteRatio))
|
||
} else if maxDeleteRatio < 0.05 {
|
||
// 删除了不到 5% 的条目 → 降低 GC 频率
|
||
interval = time.Duration(float64(interval) * 1.5)
|
||
}
|
||
if interval > ConntrackGCMaxLRUInterval {
|
||
interval = ConntrackGCMaxLRUInterval // 12 小时
|
||
}
|
||
return interval
|
||
}
|
||
```
|
||
|
||
一张 1600 万条的表,问题就在这里:
|
||
|
||
- 要删除超过 5%(避免变慢),你需要删除 80 万+ 条
|
||
- 要删除超过 25%(加快频率),你需要删除 400 万+ 条
|
||
- 起始间隔:5 分钟
|
||
- 最大间隔:12 小时
|
||
|
||
想象这个场景:
|
||
|
||
1. 节点刚上线或只跑轻量负载时,连接量一开始很低
|
||
2. 垃圾回收器一次运行删除的条目不到 5%,无法触发更频繁的周期
|
||
3. GC 间隔从几分钟开始逐步拉长,直到达到 12 小时上限。它从 7.5 分钟开始,涨到 11.25 分钟,再到 16.875 分钟,一路涨到 12 小时
|
||
4. 最终重型数据负载落到这个节点上,产生大量网络流量
|
||
5. 新连接持续填充跟踪表长达 12 小时,垃圾回收器才会再跑一次
|
||
|
||
等到垃圾回收最终执行时,连接跟踪表可能已经累积了多达 1600 万条过期条目。虽然这次 GC 可能删掉足够多的记录、暂时恢复速度,但周期之间过长的间隔本身就问题重重。这种滞后让表再次积满过期条目,迫使上一次 GC 之后漫长间隔内创建的每个 Pod 都承受一次全表顺序扫描的惨重性能代价。
|
||
|
||
|
||
|
||
## 为什么会雪崩?互斥锁、超时与重试
|
||
|
||
单个 Pod 启动缓慢已经够烦人了,但多个 Pod 同时启动时,问题急剧升级。
|
||
|
||
我们用 gops 抓取了 Cilium agent 的 goroutine dump,用一个按相似堆栈分组的脚本分析。结果很能说明问题:
|
||
|
||
```
|
||
- 57 次出现:
|
||
createEndpoint() → WaitForFirstRegeneration() → 等待 RWMutex
|
||
- 57 次出现:
|
||
regenerateBPF() → runPreCompilationSteps() → invoked
|
||
- 56 次出现:
|
||
scrubIPsInConntrackTable() → garbageCollectConntrack() → 等待 Lock
|
||
```
|
||
|
||
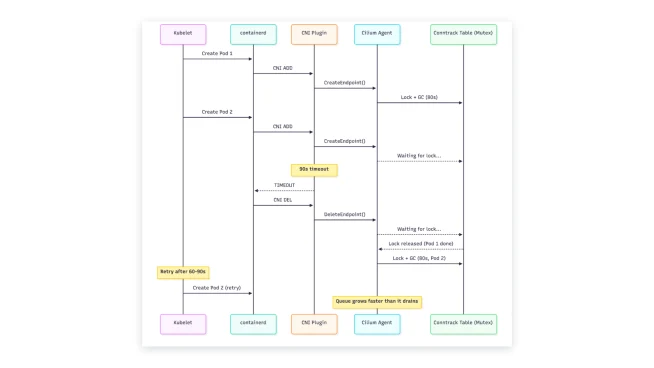
连接跟踪表上有一把**全局互斥锁**。当我们同时 spawn 50 个 Pod 时:
|
||
|
||
- Pod 1 拿到锁,开始 80 秒的表遍历
|
||
- Pod 2-50 排队等锁
|
||
- Pod 1 在 80 秒后完成
|
||
- Pod 2 拿到锁,开始又一次 80 秒遍历
|
||
- 但 Pod 2 的计时器 80 秒前就开始计时了 → 90 秒时超时
|
||
- Pod 2 超时
|
||
- Pod 3-50 根本没有机会
|
||
|
||
更糟的还在后面。CNI 在 90 秒超时之后:
|
||
|
||
- 超时向调用方返回一个错误
|
||
- **但底层工作并不会停止**:agent 仍在继续遍历
|
||
- 容器运行时(containerd)立即调用 DeleteEndpoint()
|
||
- Delete 同样需要遍历 conntrack 表
|
||
- 于是系统同时排队了创建和删除操作
|
||
|
||
然后 Kubernetes 重试:
|
||
|
||
- kubelet 的 *podWorkerLoop* 在 60-90 秒后重试(带抖动)
|
||
- 每次重试又往队列里加一次 endpoint 创建和删除请求
|
||
- 队列的增长速度超过排空速度
|
||
|
||
这些在日志里都能看到。对于 cilium-node-breaker-5 这个 Pod,我们看到了:
|
||
|
||
- 15:54:30 - 创建 endpoint(第 1 次尝试)
|
||
- 15:56:00 - 删除 endpoint(超时)
|
||
- 15:57:12 - 创建 endpoint(第 2 次尝试)
|
||
- 15:59:57 - 创建 endpoint(第 3 次尝试)
|
||
- 16:02:39 - 创建 endpoint(第 4 次尝试)
|
||
|
||
节点进入争用循环:新任务到来的速度超过旧任务完成的速度,队列永远排不空。
|
||
|
||
完整图景如下:
|
||
|
||
|
||
|
||
## 修复:一行搞定一切
|
||
|
||
经过所有这些调查,修复之简单令人扫兴。我们不能依赖自动扩缩的 GC 间隔,因为在安静的节点上它不可避免地会拉得太长。因此我们通过设置固定值,禁止 GC 间隔自动扩缩:
|
||
|
||
```
|
||
conntrackGCInterval: 60s
|
||
```
|
||
|
||
就这样。一行配置确保垃圾回收至少每分钟跑一次,无论它删了多少。我们上午 9:00 应用变更,10:00 完成 DaemonSet 滚动。结果不言自明:
|
||
|
||
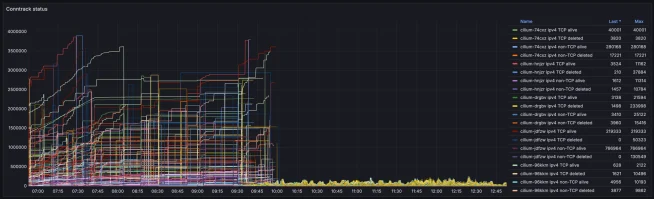
|
||
|
||
conntrack 表大小急剧下降并保持稳定。更重要的是,API 调用耗时恢复正常:
|
||
|
||
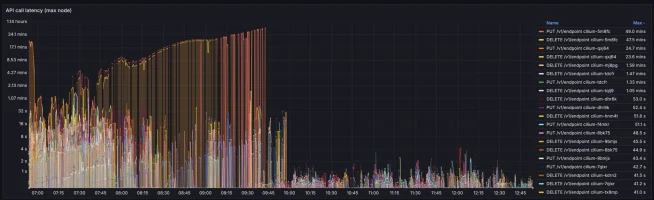
|
||
|
||
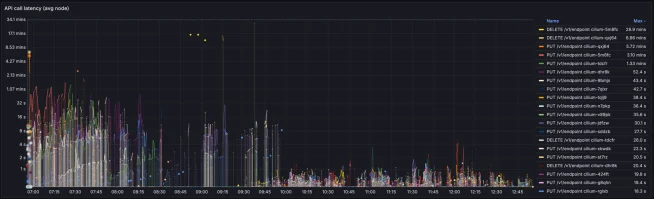
|
||
|
||
修复之后,我们再没看到一次超时错误。Pod 启动时间恢复可靠。
|
||
|
||
## 经验教训
|
||
|
||
**扩缩参数可能存在长尾交互。** 我们主动调整 bpf_map_dynamic_size_ratio 以支撑 512GB 内存机器的工作负载扩展,成功解决了最初的容量上限。但随着分析负载演进、流量增加,2TB 内存机器上动态分配出的更大表规模,暴露出它与 CNI GC 自动扩缩算法之间微妙的交互。这类扩缩参数可能要几个月、随着流量模式增长才会显现全部影响,尤其是在存在自适应后台循环的环境里。
|
||
|
||
**可观测性与全栈理解至关重要。** 日志能显示症状,但我们需要 profiling 和 tracing 才能揭示整个技术栈上的根因。容器运行时(超时、删除行为)、CNI 插件(超时值)、Cilium agent(互斥锁、GC 逻辑)和 Linux 内核(eBPF map、系统调用性能)都与理解 Pod 启动超时的成因相关。此外,用真实数字做粗略估算(napkin math)威力巨大。一旦我们拿到关键数字——每秒 20 万次系统调用、1200 万条表条目、90 秒超时——远在理解完整链条之前我们就锁定了根因。永远度量系统真实的性能特征,而不是只盯着理论极限。
|
||
|
||
**自动扩缩算法需要边界。** Cilium 的 GC 间隔自动扩缩对大多数部署是合理的:删除得多就多跑 GC,删得少就少跑以省 CPU。但算法没有考虑负载多变的情况:一台机器长期连接量很低,之后引入一个 Pod 就可能迎来极高的连接量。算法也没有考虑超大的表,在那里"5% 的条目"是个巨大的绝对数字。12 小时的最大间隔对我们的负载来说太长了。不仔细推敲边界情况的自动扩缩可能适得其反。
|
||
|
||
**超时并不会停止工作。** 当 CNI 超时时,我们以为工作会停止。并没有。agent 在后台继续处理,新的请求不断入队。这是分布式系统中的常见模式:超时保护的是调用方,但不一定会取消操作。需要时请显式地做取消。
|
||
|
||
**把 conntrack 健康当作一等运维指标。** 健康集群与争用循环的区别,清楚地体现在一些我们原本没盯的指标上:
|
||
|
||
- GC 耗时 - cilium_datapath_conntrack_gc_duration_seconds - 从 1 秒跳到 80 秒
|
||
- 表大小 - cilium_datapath_conntrack_gc_entries - 700 万条,大部分已过期
|
||
|
||
对于任何跑动态负载的 Cilium 部署,我们都建议主动对这两个指标告警,并设置 `conntrackGCInterval: 60s`。不要为了安静期的 CPU 节省,牺牲繁忙期的 Pod 启动稳定性。
|
||
|
||
## 结论
|
||
|
||
最终,一行配置解决了那个影响我们大数据平台新 Pod 启动的神秘超时:conntrackGCInterval: 60s。调查揭示,Pod 超时的根因是 Cilium 自动扩缩的垃圾回收算法——它允许清理间隔一直涨到 12 小时,导致过期条目大规模堆积,落入线性时间遍历的陷阱。
|
||
|
||
这次经历在系统弹性与全栈理解的必要性上给了我们重要启示。我们学到,扩缩参数和资源分配存在长尾交互,往往要几个月后随工作负载演进才浮出水面。我们还发现,自动扩缩算法需要严格的边界,以防止边缘情况下的意外性能退化——比如我们高资源机器上起伏不定的连接量。调查还强调,超时往往只保护调用方,不会停止底层工作,可能触发重试的争用循环——而这类问题只能靠对互斥锁、系统调用和 eBPF 内部机制的深度可观测性才能诊断。
|
||
|
||
展望未来,我们必须自问:基础设施里那些自适应行为到底是在保护我们,还是在掩盖只在峰值容量下才显现的低效?把 conntrack 健康当作一等运维指标、把可靠性置于微不足道的 CPU 节省之上,我们就能构建更健壮的系统。还有,记住:如果你在 CNI 里看到神秘超时——有时候答案就藏在每秒 42.6 万次系统调用里。 |